 AI 智链谷
 问苏一二 ↗
社区交流 ·
嵌入
开源教程转载|嵌入。Microsoft 及项目贡献者编写,智链谷平台运营整理。
> 开源教程转载 · 由智链谷平台运营账号整理发布。作者:Microsoft 及项目贡献者。
> [查看原文](https://github.com/microsoft/AI-For-Beginners/blob/392d0df1b2647cbee104942390551f1ed9e072c8/translations/zh-CN/lessons/5-NLP/14-Embeddings/README.md) · MIT 许可,完整声明见文末。
# 嵌入
## [课前测验](https://ff-quizzes.netlify.app/en/ai/quiz/27)
在基于 BoW 或 TF/IDF 训练分类器时,我们使用的是长度为 `vocab_size` 的高维词袋向量,并且我们显式地将低维位置表示向量转换为稀疏的独热表示。然而,这种独热表示并不节省内存。此外,每个单词都被独立对待,即独热编码的向量无法表达单词之间的语义相似性。
**嵌入**的想法是用低维密集向量来表示单词,这些向量能够以某种方式反映单词的语义含义。稍后我们会讨论如何构建有意义的词嵌入,但现在我们只需将嵌入理解为一种降低单词向量维度的方法。
嵌入层会将一个单词作为输入,并生成指定 `embedding_size` 的输出向量。从某种意义上说,它与 `Linear` 层非常相似,但它不需要独热编码向量,而是可以直接接受单词编号作为输入,从而避免创建大型独热编码向量。
通过在分类器网络中使用嵌入层作为第一层,我们可以从词袋模型切换到 **嵌入袋** 模型。在嵌入袋模型中,我们首先将文本中的每个单词转换为对应的嵌入,然后对所有这些嵌入计算某种聚合函数,例如 `sum`、`average` 或 `max`。
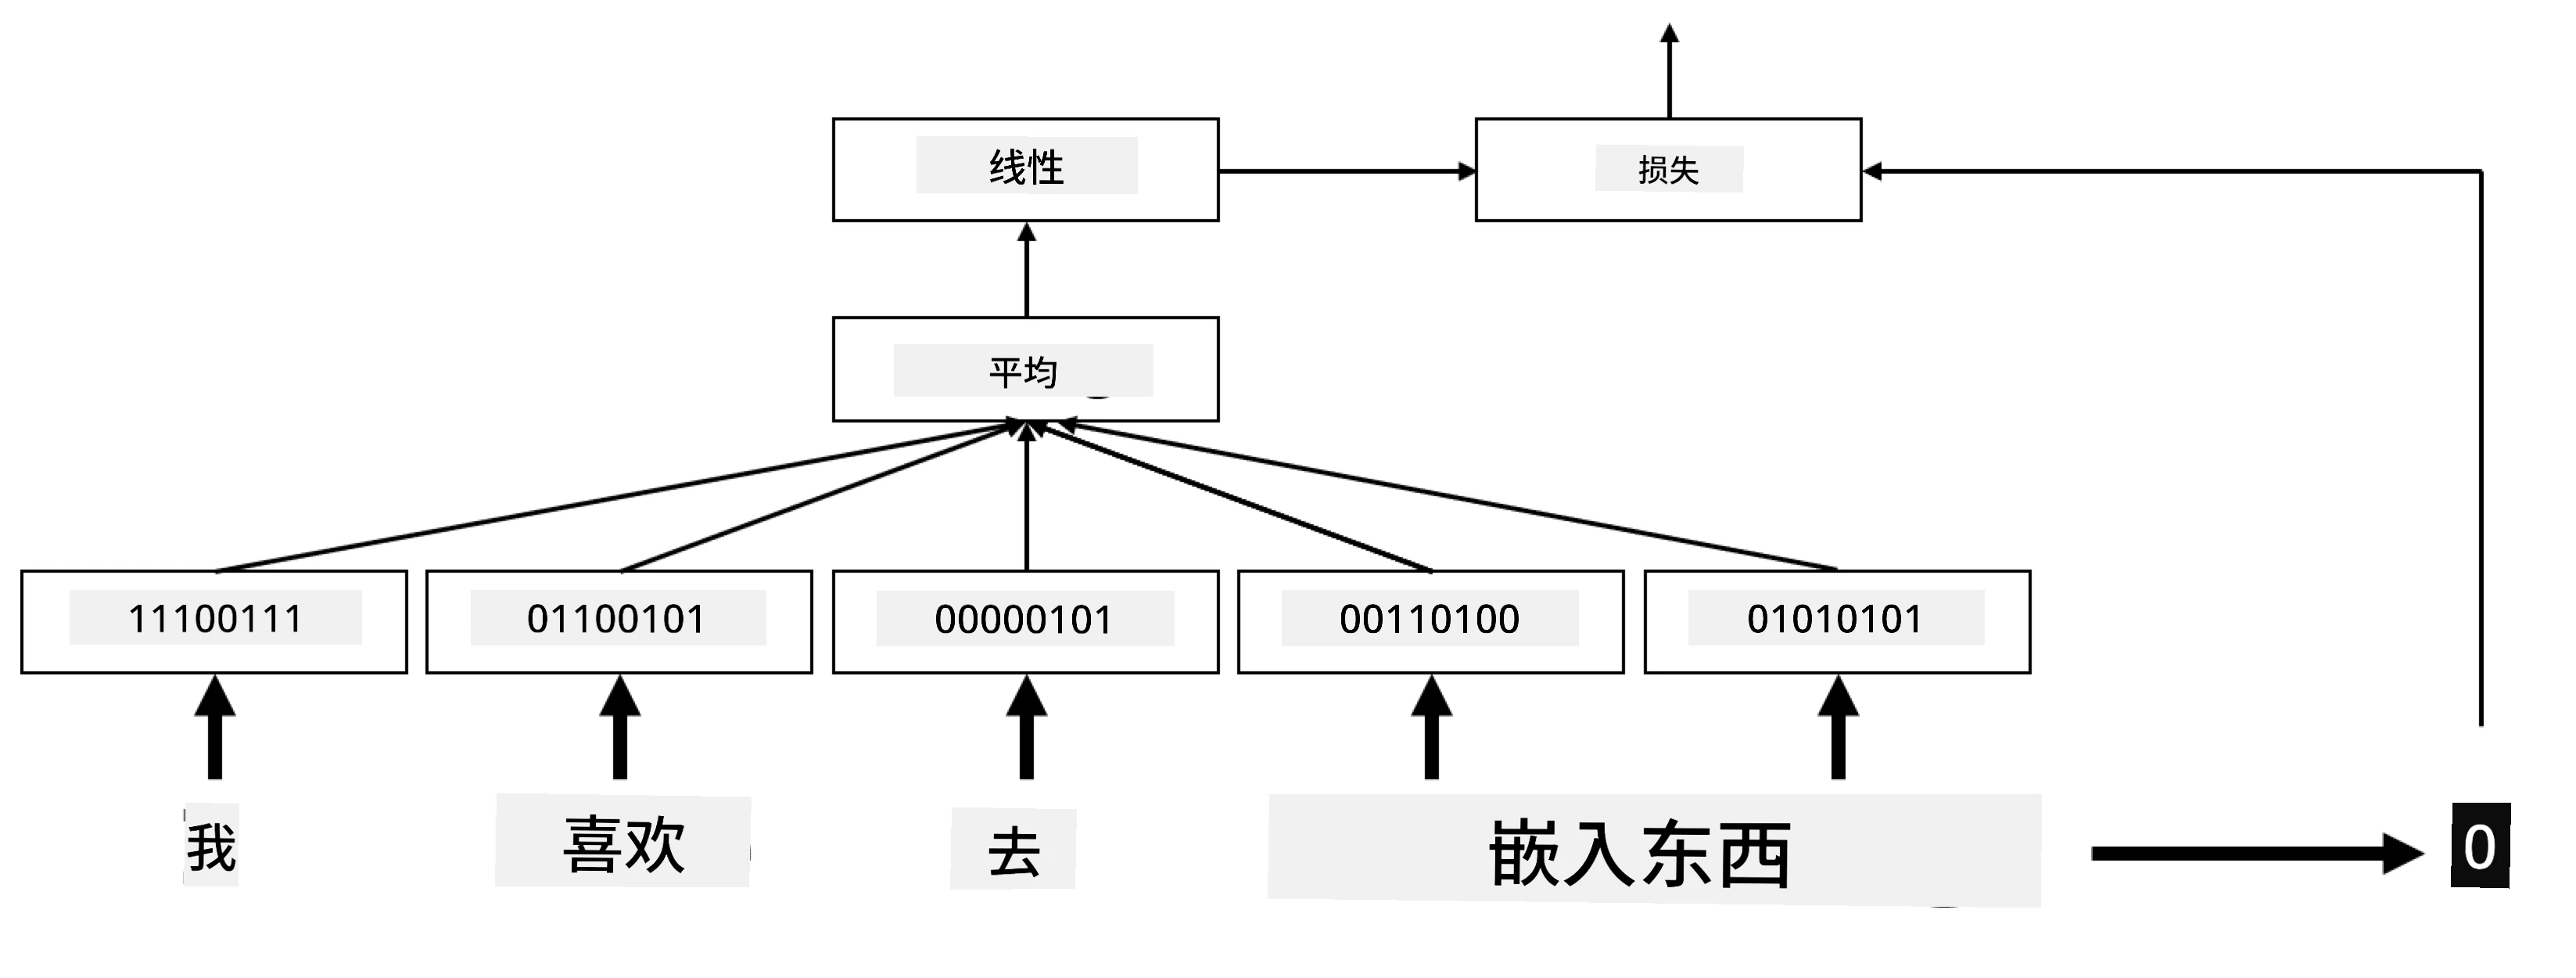
> 图片由作者提供
## ✍️ 练习:嵌入
通过以下笔记本继续学习:
* [使用 PyTorch 的嵌入](https://github.com/microsoft/AI-For-Beginners/blob/392d0df1b2647cbee104942390551f1ed9e072c8/translations/zh-CN/lessons/5-NLP/14-Embeddings/EmbeddingsPyTorch.ipynb)
* [使用 TensorFlow 的嵌入](https://github.com/microsoft/AI-For-Beginners/blob/392d0df1b2647cbee104942390551f1ed9e072c8/translations/zh-CN/lessons/5-NLP/14-Embeddings/EmbeddingsTF.ipynb)
## 语义嵌入:Word2Vec
虽然嵌入层可以学习将单词映射到向量表示,但这种表示不一定具有很强的语义意义。如果我们能学习一种向量表示,使得相似单词或同义词在某种向量距离(例如欧几里得距离)上彼此接近,那就更好了。
为此,我们需要以特定方式在大量文本上预训练嵌入模型。一种训练语义嵌入的方法叫做 [Word2Vec](https://en.wikipedia.org/wiki/Word2vec)。它基于两种主要架构来生成单词的分布式表示:
- **连续词袋** (CBoW) —— 在这种架构中,我们训练模型根据上下文预测单词。给定 ngram $(W_{-2},W_{-1},W_0,W_1,W_2)$,模型的目标是根据 $(W_{-2},W_{-1},W_1,W_2)$ 预测 $W_0$。
- **连续跳词模型** (Skip-Gram) —— 与 CBoW 相反,模型使用上下文窗口中的单词来预测当前单词。
CBoW 速度更快,而 Skip-Gram 虽然较慢,但在表示不常见单词方面表现更好。
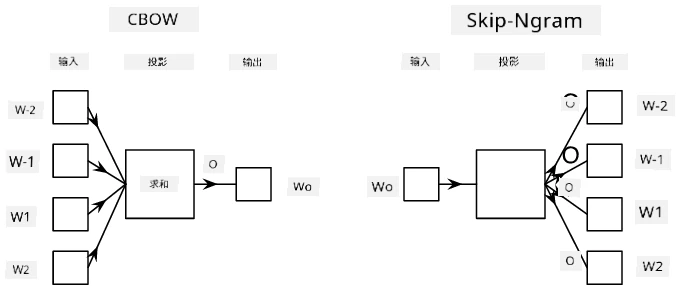
> 图片来源于 [这篇论文](https://arxiv.org/pdf/1301.3781.pdf)
Word2Vec 预训练嵌入(以及其他类似模型,例如 GloVe)也可以替代神经网络中的嵌入层使用。然而,我们需要处理词汇表问题,因为用于预训练 Word2Vec/GloVe 的词汇表可能与我们文本语料库中的词汇表不同。查看上述笔记本,了解如何解决这个问题。
## 上下文嵌入
传统的预训练嵌入表示(如 Word2Vec)的一个主要限制是词义消歧问题。虽然预训练嵌入可以捕捉单词在上下文中的部分含义,但每个单词的所有可能含义都被编码到同一个嵌入中。这可能会在下游模型中引发问题,因为许多单词(例如“play”)的含义会根据使用的上下文而有所不同。
例如,“play”在以下两个句子中的含义完全不同:
- 我去剧院看了一场**戏剧**。
- 约翰想和朋友们**玩耍**。
上述预训练嵌入将“play”的这两种含义表示为同一个嵌入。为了克服这一限制,我们需要基于**语言模型**构建嵌入,该模型在大量文本语料库上进行训练,并且*了解*单词在不同上下文中的组合方式。讨论上下文嵌入超出了本教程的范围,但我们将在课程后续讨论语言模型时回到这个话题。
## 总结
在本课中,你学习了如何在 TensorFlow 和 PyTorch 中构建和使用嵌入层,以更好地反映单词的语义含义。
## 🚀 挑战
Word2Vec 已被用于一些有趣的应用,包括生成歌词和诗歌。看看[这篇文章](https://www.politetype.com/blog/word2vec-color-poems),作者在其中介绍了如何使用 Word2Vec 生成诗歌。还可以观看[Dan Shiffmann 的这个视频](https://www.youtube.com/watch?v=LSS_bos_TPI&ab_channel=TheCodingTrain),了解该技术的另一种解释。然后尝试将这些技术应用到你自己的文本语料库中,可以从 Kaggle 获取数据。
## [课后测验](https://ff-quizzes.netlify.app/en/ai/quiz/28)
## 复习与自学
阅读这篇关于 Word2Vec 的论文:[Efficient Estimation of Word Representations in Vector Space](https://arxiv.org/pdf/1301.3781.pdf)
## [作业:笔记本](https://github.com/microsoft/AI-For-Beginners/blob/392d0df1b2647cbee104942390551f1ed9e072c8/translations/zh-CN/lessons/5-NLP/14-Embeddings/assignment.md)
---
---
## 版权与许可
```text
MIT License
Copyright (c) Microsoft Corporation.
Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:
The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE
```