 AI 智链谷
 问苏一二 ↗
社区交流 ·
探索和比较不同的大型语言模型(LLMs)
开源教程转载|探索和比较不同的大型语言模型(LLMs)。Microsoft 及项目贡献者编写,智链谷平台运营整理。
> 开源教程转载 · 由智链谷平台运营账号整理发布。作者:Microsoft 及项目贡献者。
> [查看原文](https://github.com/microsoft/generative-ai-for-beginners/blob/d8ec07e31c4b32bd283d565c1abd9b58bb5cf2e8/translations/zh-CN/02-exploring-and-comparing-different-llms/README.md) · MIT 许可,完整声明见文末。
# 探索和比较不同的大型语言模型(LLMs)
[](https://youtu.be/KIRUeDKscfI?si=8BHX1zvwzQBn-PlK)
> _点击上方图片观看本课视频_
在上一课中,我们已经了解了生成式人工智能如何改变技术格局,大型语言模型(LLMs)的工作原理,以及像我们这样创业公司如何将其应用于业务场景并实现增长!本章我们将对不同类型的大型语言模型进行比较与对比,了解它们的优缺点。
我们创业旅程的下一步是探索当前大型语言模型的格局,了解哪些适合我们的应用场景。
## 简介
本课将涵盖:
- 当前格局下不同类型的LLMs。
- 在Azure中针对您的用例测试、迭代和比较不同模型。
- 如何部署LLM。
## 学习目标
完成本课后,您将能够:
- 为您的用例选择合适的模型。
- 了解如何测试、迭代和提升模型性能。
- 了解企业如何部署模型。
## 理解不同类型的LLMs
LLMs 可以基于其架构、训练数据和使用场景进行多种分类。了解这些差异将帮助我们的创业公司为场景选择合适模型,并理解如何测试、迭代和提升性能。
LLM模型有许多不同类型,您的选择取决于您应用的目标、数据量、预算等。
根据您打算用于文本、音频、视频、图像生成等,可能会选择不同类型的模型。
- <strong>音频与语音识别</strong>。Whisper风格模型仍然是通用的语音识别模型,但生产环境中现在也有更新的语音转文字模型,如 `gpt-4o-transcribe`、`gpt-4o-mini-transcribe` 以及说话人分离版本。请根据语言覆盖范围、说话人分离、实时支持、延迟和成本等因素评估您的场景。更多内容请参见 [OpenAI 语音转文字文档](https://platform.openai.com/docs/guides/speech-to-text?WT.mc_id=academic-105485-koreyst)。
- <strong>图像生成</strong>。DALL-E 和 Midjourney 是知名的图像生成选项,但当前OpenAI图像API主要基于 `gpt-image-2` 等GPT图像模型,Stable Diffusion、Imagen、Flux及其他模型家族也是常见选择。请比较提示准确性、编辑支持、风格控制、安全需求和许可情况。更多信息请参见 [OpenAI 图像生成指南](https://platform.openai.com/docs/guides/images?WT.mc_id=academic-105485-koreyst) 和本课程第9章。
- <strong>文本生成</strong>。文本模型涵盖前沿模型、推理模型、小型低延迟模型和开源权重模型。当前示例包括OpenAI GPT-5.x系列,Anthropic Claude 4.x系列,Google Gemini 3.x系列,Meta Llama 4系列,以及Mistral模型。不要仅根据发布日期或价格选择,应比较任务质量、延迟、上下文窗口、工具使用、安全行为、区域可用性和总成本。可参考 [Microsoft Foundry 模型目录](https://ai.azure.com/catalog?WT.mc_id=academic-105485-koreyst) 比较Azure中可用的模型。
- <strong>多模态</strong>。许多当前模型能处理文本之外的输入。一些支持图像、音频或视频输入;一些能调用工具;专用模型还能生成图像、音频或视频。例如,当前OpenAI模型支持文本和图像输入,Gemini模型根据变体支持文本、代码、图像、音频和视频输入,Llama 4 Scout 和 Maverick 是开源权重的本地多模态模型。构建工作流前务必检查每个模型卡支持的输入和输出模态。
选择模型意味着您获得了一些基本能力,但这可能还不够。通常,您有公司特定数据需要以某种方式告知LLM。下面章节会介绍几种处理方法。
### 基础模型 versus LLMs
“基础模型”这一术语由斯坦福研究人员[提出](https://arxiv.org/abs/2108.07258?WT.mc_id=academic-105485-koreyst),定义为满足某些标准的AI模型,例如:
- <strong>它们通过无监督学习或自监督学习训练</strong>,即基于未标注的多模态数据,不需要人工注释或标注数据完成训练。
- <strong>它们是非常大型的模型</strong>,基于非常深的神经网络训练,参数量达数十亿。
- **它们通常被设计为其他模型的“基础”**,意味着它们可以作为其他模型构建的起点,通过微调进一步开发。
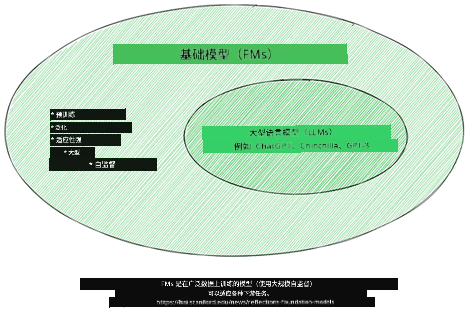
图片来源:[基础模型和大型语言模型的基础指南 | Babar M Bhatti | Medium
](https://thebabar.medium.com/essential-guide-to-foundation-models-and-large-language-models-27dab58f7404)
为更清楚区分,举ChatGPT为例。早期版本基于GPT-3.5作为基础模型,OpenAI随后通过聊天特定数据和调校技术打造出更适合对话场景(如聊天机器人)的微调版本。现代AI服务通常在多个模型变体之间路由,服务名称和底层模型名称不一定相同。
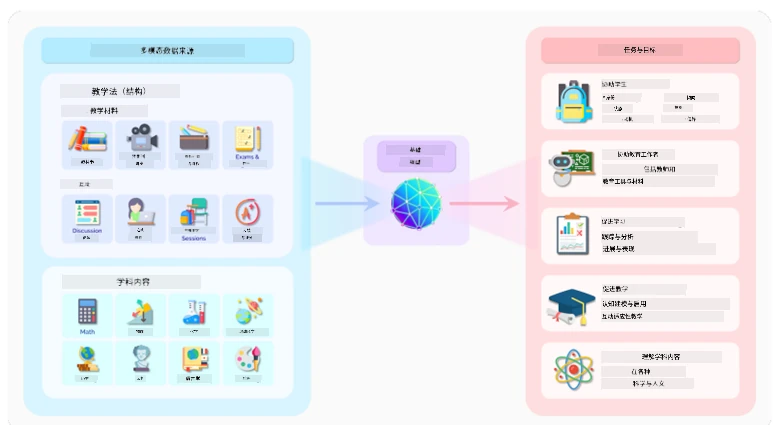
图片来源: [2108.07258.pdf (arxiv.org)](https://arxiv.org/pdf/2108.07258.pdf?WT.mc_id=academic-105485-koreyst)
### 开源权重/开源模型 versus 专有模型
另一个LLMs分类方式是基于是否开源权重、开源还是专有。
开源和开源权重模型会提供模型文件供检查、下载或定制,但许可证不同。有些完全开源,有些开源权重但使用有限制。它们适合希望更好控制部署、数据存储位置、成本和定制化的企业。但团队仍需审查许可条款、服务成本、维护、安全更新和评估质量后方可投入生产。示例包括 [Meta Llama 4](https://ai.meta.com/blog/llama-4-multimodal-intelligence/?WT.mc_id=academic-105485-koreyst)、部分 [Mistral模型](https://docs.mistral.ai/models/overview?WT.mc_id=academic-105485-koreyst) 和很多托管在 [Hugging Face](https://huggingface.co/models?WT.mc_id=academic-105485-koreyst) 的模型。
专有模型由供应商拥有和托管。它们通常针对托管的生产使用进行了优化,可提供强大的支持、安全系统、工具集成和规模能力。但客户通常无法检查或修改模型权重,需审阅供应商隐私、保留、合规和可接受使用条款。示例包括 [OpenAI模型](https://platform.openai.com/docs/models?WT.mc_id=academic-105485-koreyst)、[Google Gemini](https://deepmind.google/models/gemini/pro/?WT.mc_id=academic-105485-koreyst) 和 [Anthropic Claude](https://platform.claude.com/docs/en/about-claude/models/overview?WT.mc_id=academic-105485-koreyst)。
### 嵌入向量 versus 图像生成 versus 文本和代码生成
LLMs 也可以根据输出类型分类。
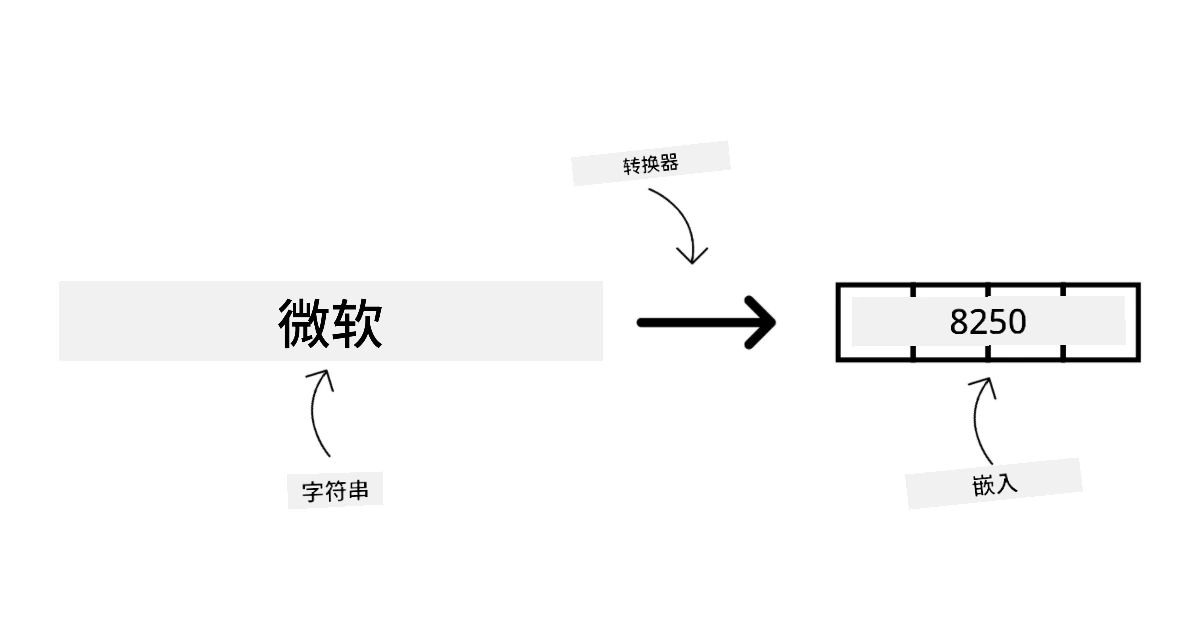
嵌入向量模型是一类将文本转换成数值形式(称为嵌入向量)的模型,嵌入向量是输入文本的数值表示。嵌入向量便于机器理解单词或句子之间的关系,可以作为其他模型的输入,例如分类模型或在数值数据上表现更优的聚类模型。嵌入模型常用于迁移学习,即为丰富数据的代理任务构建模型,然后重用该模型权重(嵌入向量)用于下游任务。该类别示例为 [OpenAI embeddings](https://platform.openai.com/docs/models/embeddings?WT.mc_id=academic-105485-koreyst)。
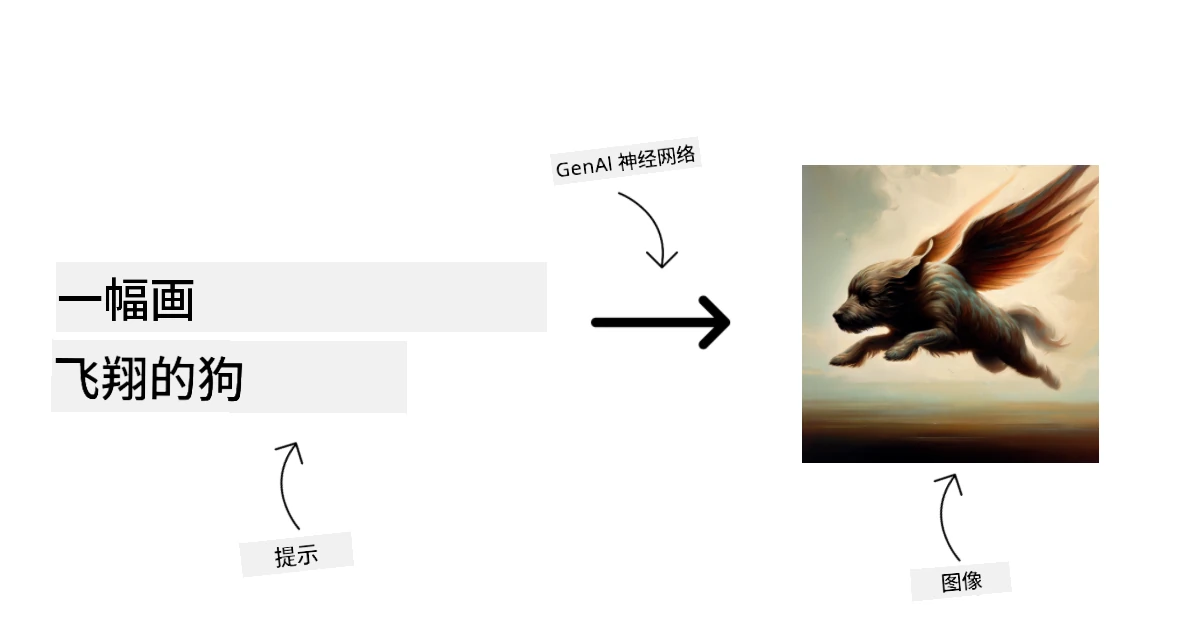
图像生成模型用于生成图像,常用于图像编辑、图像合成和图像转换。图像生成模型通常在大规模图像数据集上训练,如 [LAION-5B](https://laion.ai/blog/laion-5b/?WT.mc_id=academic-105485-koreyst),能生成新图像或用修补、超分辨率、着色技术编辑已有图像。示例包括 [GPT 图像模型](https://platform.openai.com/docs/guides/images?WT.mc_id=academic-105485-koreyst)、[Stable Diffusion 模型](https://github.com/Stability-AI/StableDiffusion?WT.mc_id=academic-105485-koreyst) 和 Imagen 模型。
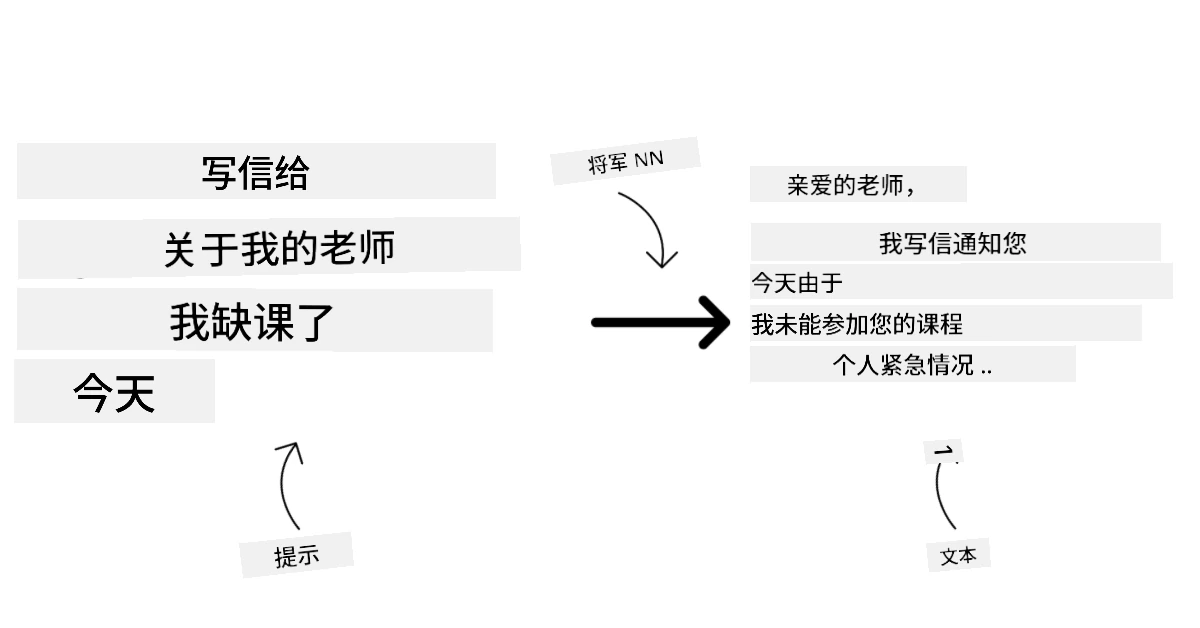
文本和代码生成模型生成文本或代码,常用于文本摘要、翻译及问答。文本生成模型通常在大规模文本数据集上训练,如 [BookCorpus](https://www.cv-foundation.org/openaccess/content_iccv_2015/html/Zhu_Aligning_Books_and_ICCV_2015_paper.html?WT.mc_id=academic-105485-koreyst),能生成新文本或回答问题。代码生成模型,如 [CodeParrot](https://huggingface.co/codeparrot?WT.mc_id=academic-105485-koreyst),通常在大规模代码数据集如GitHub上训练,能生成新代码或修复现有代码中的错误。
### 编码器-解码器架构 versus 仅解码器架构
讲解LLMs不同架构时,我们用一个类比来说明。
想象你的经理给你一个为学生编写测验题的任务。你有两位同事:一位负责出题内容,一位负责审核试题。
内容出题者类似仅解码器模型:他们能看主题,查看你已写内容,然后基于上下文继续生成内容。他们擅长写有吸引力和信息量的内容,但如果任务只是分类、检索或编码信息,往往不是最佳选择。仅解码器模型家族示例包括 GPT 和 Llama 模型。
审核者类似仅编码器模型,他们阅读已写课程和答案,发现它们之间的关系并理解上下文,但不擅长生成内容。仅编码器模型的示例是 BERT。
想象还有人能同时出题和审核测验,这就是编码器-解码器模型。示例包括 BART 和 T5。
### 服务 versus 模型
现在,讨论服务和模型的区别。服务是云服务提供商提供的产品,通常是模型、数据和其他组件的组合。模型是服务的核心组成部分,通常是基础模型如LLM。
服务通常针对生产环境优化,相较于模型更易用,通常通过图形用户界面提供。然而服务不一定免费,使用时可能需订阅或付费,以换取服务方设备和资源的使用,优化开支并便于扩展。示例服务是 [Azure OpenAI Service](https://learn.microsoft.com/azure/ai-foundry/openai/overview?WT.mc_id=academic-105485-koreyst),其计费按用量付费计划,用户根据使用量付费。Azure OpenAI Service 在模型能力基础上还提供企业级安全和负责任的AI框架。
模型是神经网络产物:参数、权重、架构、分词器和配置。要在本地或私有环境运行模型,需要适当硬件、服务基础设施、监控,以及兼容的开源/开权许可或商业许可。开权模型如 Llama 4 或 Mistral 可自托管,但仍需计算资源和运维能力。
## 如何在Azure上测试和迭代不同模型以理解性能
一旦我们的团队探索了当前的 LLM 领域并确定了一些适合他们场景的良好候选模型,下一步就是在他们的数据和工作负载上对这些模型进行测试。这是一个通过实验和测量进行的迭代过程。
我们在前面提到的大多数模型(OpenAI 模型、像 Llama 4 和 Mistral 这样的开源权重模型,以及 Hugging Face 模型)都可在 [Microsoft Foundry Models](https://learn.microsoft.com/azure/foundry/concepts/foundry-models-overview?WT.mc_id=academic-105485-koreyst) 中获得。
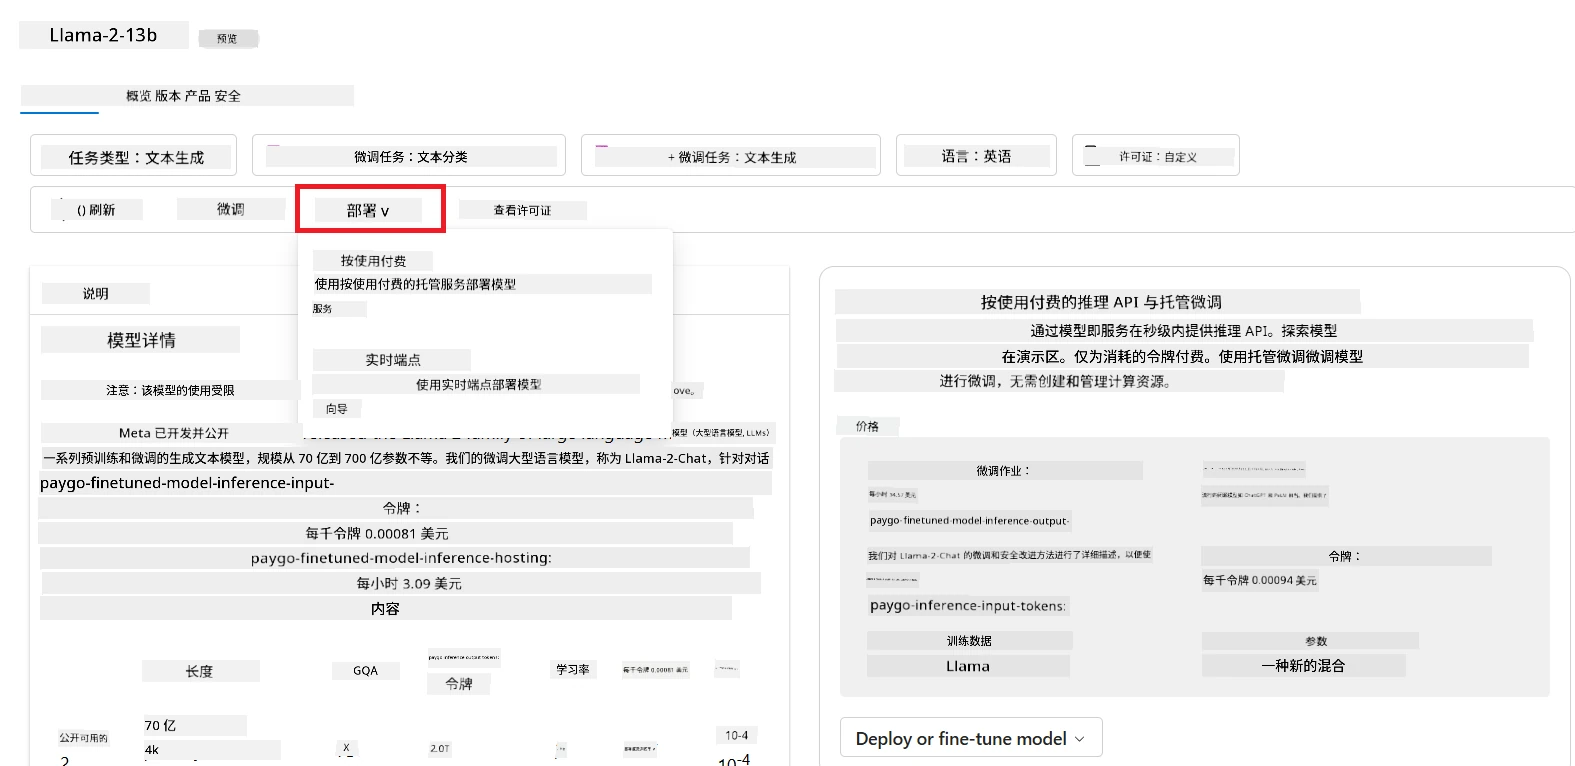
[Microsoft Foundry](https://learn.microsoft.com/azure/foundry/what-is-foundry?WT.mc_id=academic-105485-koreyst),前身为 Azure AI Studio/Azure AI Foundry,是一个用于构建 AI 应用和代理的统一 Azure 平台。它帮助开发者管理从实验和评估到部署、监控和治理的整个生命周期。Microsoft Foundry 中的模型目录使用户能够:
- 在目录中查找感兴趣的基础模型,包括 Azure 销售的模型以及来自合作伙伴和社区提供者的模型。用户可以按任务、提供者、许可证、部署选项或名称进行筛选。
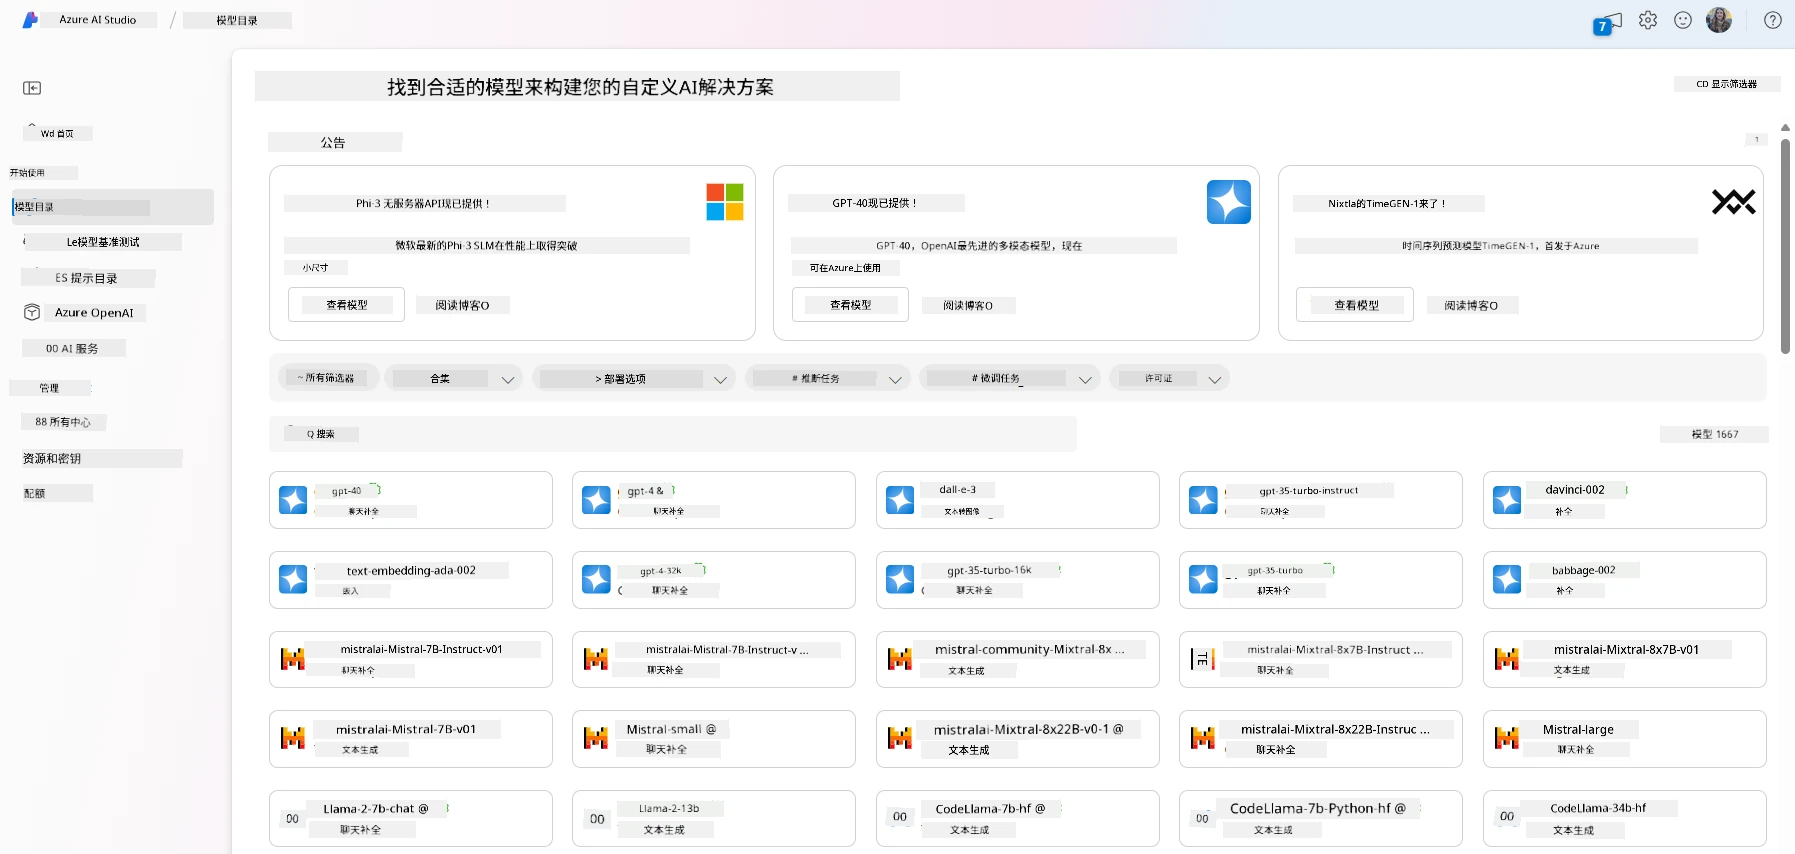
- 查看模型卡,包括对预期用途和训练数据的详细描述、代码示例以及内部评估库中的评估结果。
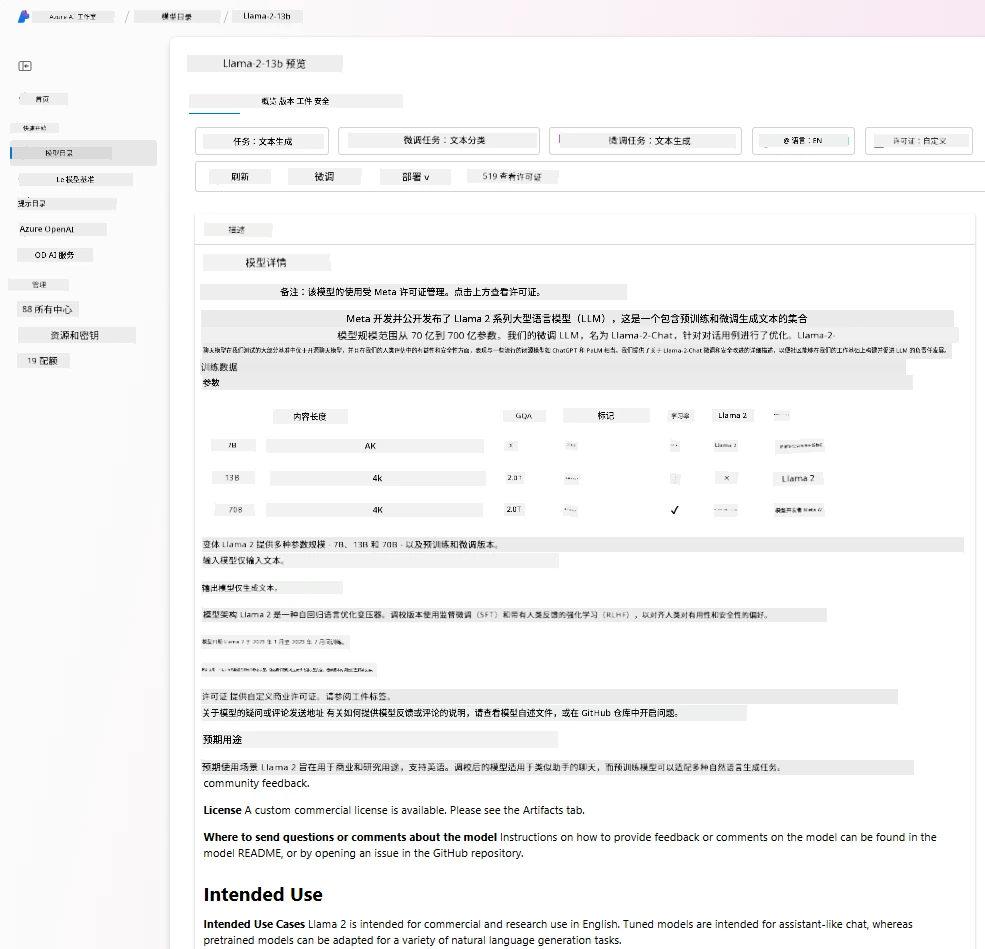
- 通过[模型基准测试](https://learn.microsoft.com/azure/ai-foundry/concepts/model-benchmarks?WT.mc_id=academic-105485-koreyst)面板比较业内可用模型和数据集的基准,评估哪个模型满足业务场景需求。
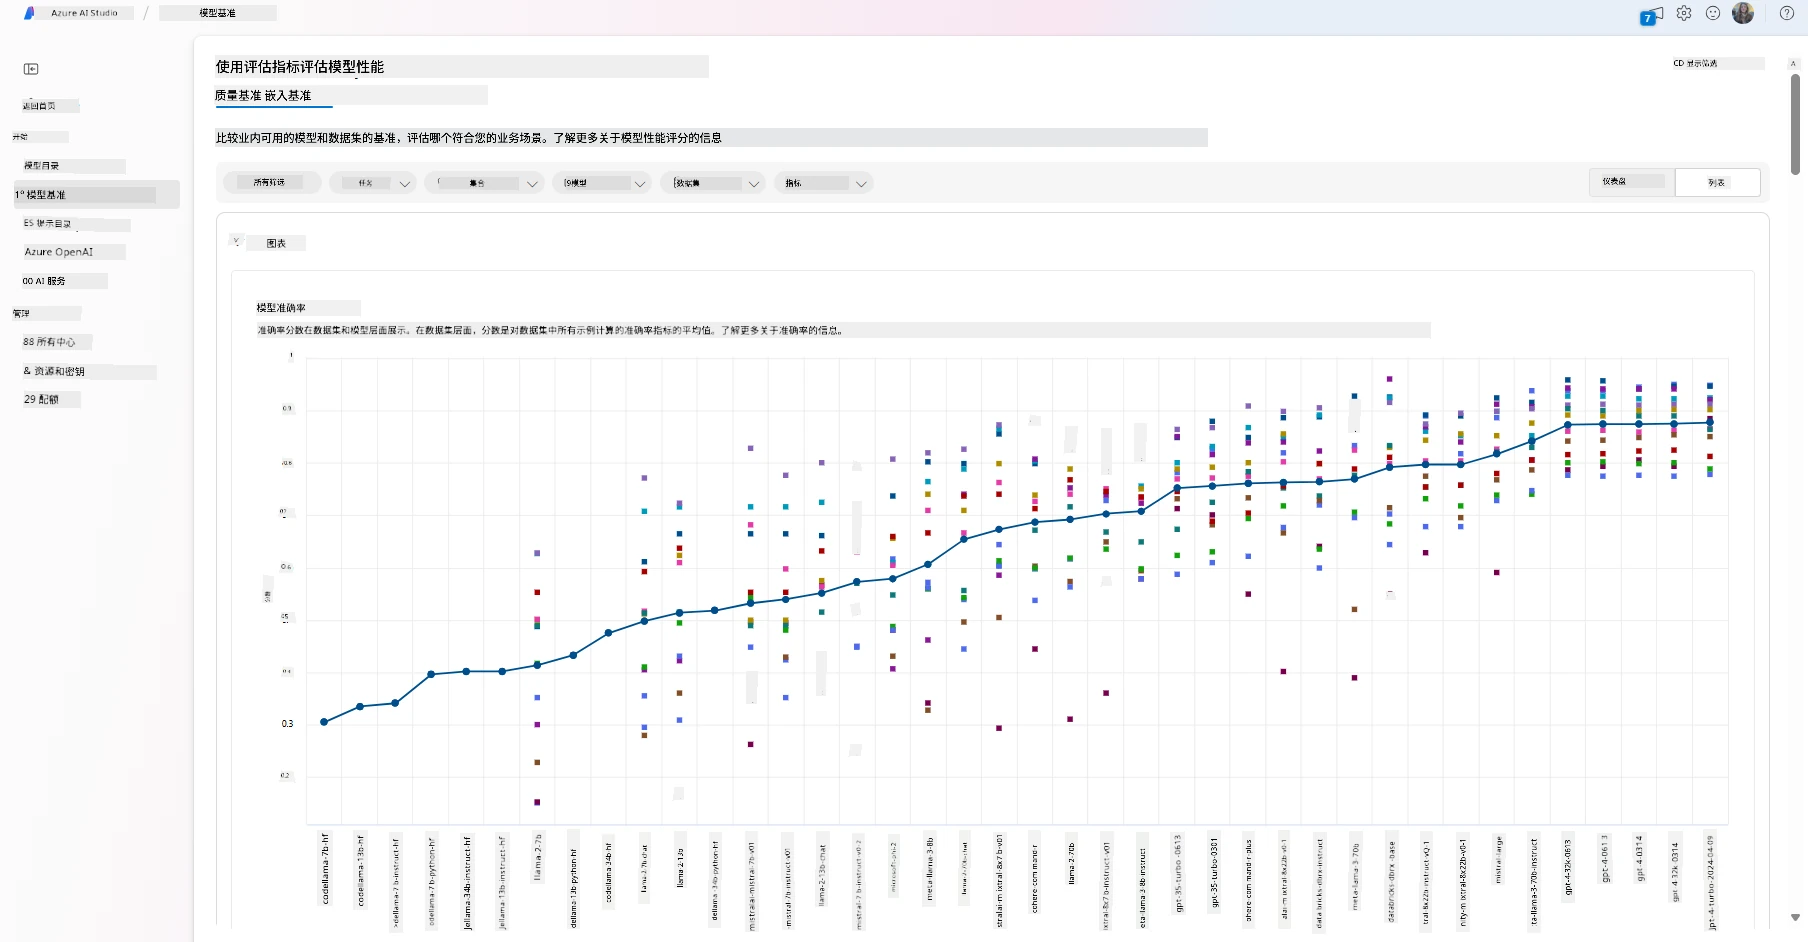
- 利用 Microsoft Foundry 的实验和跟踪功能,在自定义训练数据上微调支持的模型,以提高模型在特定工作负载上的性能。
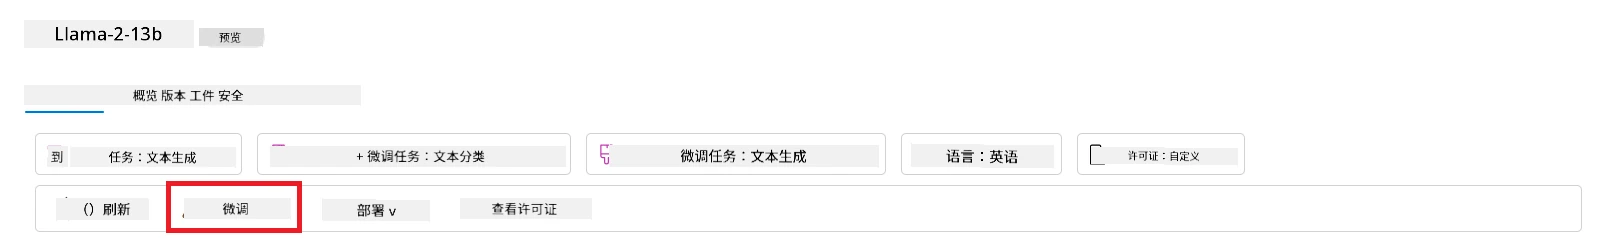
- 将原始预训练模型或微调版本部署到远程实时推理端点,使用托管计算或无服务器部署选项,使应用程序能够调用模型。
> [!NOTE]
> 并非目录中的所有模型当前都支持微调和/或按需付费部署。请查看模型卡以了解模型的能力和限制详情。
## 提升 LLM 结果
我们与创业团队一起探索了不同类型的 LLM 和一个云平台(Microsoft Foundry),该平台使我们能够比较不同模型,在测试数据上评估它们,提升性能,并部署到推理端点。
但他们应何时考虑微调模型而不是使用预训练模型?还有哪些其他方法可以提升模型在特定工作负载上的表现?
企业可以采用多种方法从 LLM 中获得所需结果。部署 LLM 时,可以选择不同类型、不同训练程度的模型,其复杂度、成本和质量各不相同。以下是一些不同的方法:
- <strong>带上下文的提示工程</strong>。其思路是在提示时提供足够多的上下文,以确保获得所需的回答。
- **检索增强生成 (RAG)**。你的数据例如可能存在于数据库或网络端点中,为确保在提示时包含这些数据或其子集,可以检索相关数据,使其成为用户提示的一部分。
- <strong>微调模型</strong>。在此方案中,您在自己的数据上进一步训练模型,使模型对您的需求更准确、更响应,但可能成本较高。
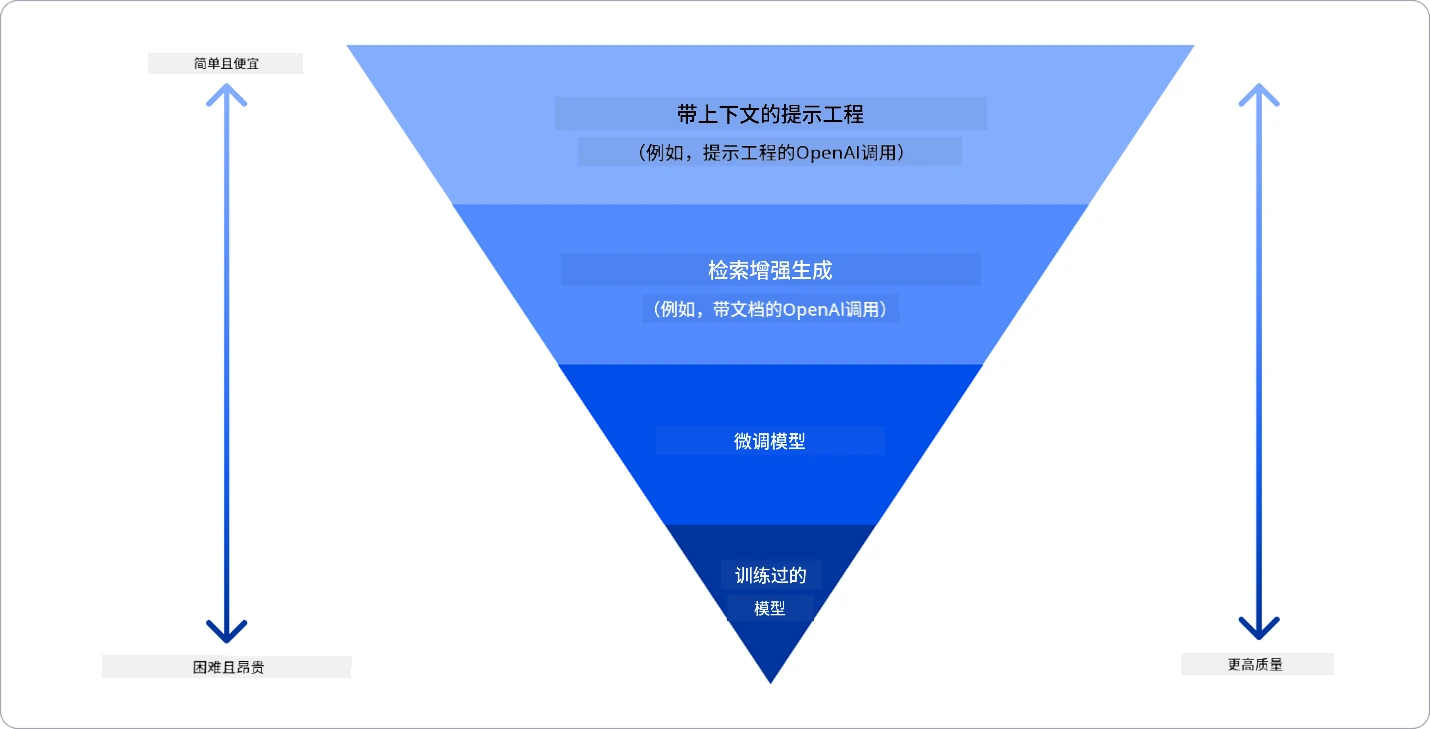
图片来源:[Four Ways that Enterprises Deploy LLMs | Fiddler AI Blog](https://www.fiddler.ai/blog/four-ways-that-enterprises-deploy-llms?WT.mc_id=academic-105485-koreyst)
### 带上下文的提示工程
预训练的 LLM 在通用自然语言任务上表现良好,即使只用简短提示(如完成一句话或回答一个问题),也能进行所谓的“零样本”学习。
但是,用户越能够通过详细请求和示例——上下文——来构造查询,答案就越准确且越符合用户期望。如果提示包含一个示例,则称为“一次学习”,如果包含多个示例,则称为“少量学习”。
带上下文的提示工程是最具成本效益的入门方法。
### 检索增强生成 (RAG)
LLM 有一个限制,只能使用训练时使用的数据来生成答案。这意味着它们不了解训练后发生的事实,也无法访问非公开信息(如公司数据)。
这可以通过 RAG 技术克服,该技术通过文档块的形式将外部数据增强到提示中,考虑提示长度限制。此技术由向量数据库工具支持(如 [Azure Vector Search](https://learn.microsoft.com/azure/search/vector-search-overview?WT.mc_id=academic-105485-koreyst)),它从多种预定义数据源检索有用数据块并将其添加到提示上下文中。
当企业没有足够的数据、时间或资源来微调 LLM,但仍希望提升特定工作负载的性能并降低幻觉、过时或不支持回答的风险时,这种技术非常有用。
### 微调模型
微调是利用迁移学习将模型“适配”到下游任务或解决特定问题的过程。不同于少量学习和 RAG,它会生成一个新模型,更新权重和偏置。它需要一组训练实例,包括单个输入(提示)及其对应输出(完成)。
这种方法在以下情况下是首选:
- <strong>使用更小的特定任务模型</strong>。企业想微调一个较小的模型执行特定狭窄任务,而不是反复提示更大的前沿模型,从而获得更具成本效益且更快速的解决方案。
- <strong>考虑延迟</strong>。某些用例对延迟要求高,不适合使用非常长的提示,或需要学习的示例数量超过提示长度限制。
- <strong>适应稳定行为</strong>。企业有许多高质量的示例,想要模型始终遵循任务模式、输出格式、语气或特定领域风格。如果主要问题是实时事实或经常变化的私有知识,使用 RAG 而不是仅依赖微调。
### 训练好的模型
从头训练大型语言模型无疑是最困难且最复杂的方法,需大量数据、熟练资源和适当的计算能力。只有在企业具备特定领域的用例和大量领域数据时,才应考虑此选项。
## 知识考察
什么方法可以有效提升大型语言模型的完成效果?
1. 结合上下文的提示工程
1. RAG
1. 微调模型
答:这三种方法都能帮助提升效果。可先从提示工程和上下文入手,快速改进;当模型需要当前事实或私有业务数据时,使用 RAG;当有足够的高质量示例且需要模型始终遵循任务、格式、语气或领域模式时,选择微调。
## 🚀 挑战
详细了解如何为您的业务[使用 RAG](https://learn.microsoft.com/azure/search/retrieval-augmented-generation-overview?WT.mc_id=academic-105485-koreyst)。
## 做得好,继续学习
完成本课后,查看我们的[生成式 AI 学习合集](https://aka.ms/genai-collection?WT.mc_id=academic-105485-koreyst),继续提升您的生成式 AI 知识!
前往第3课,我们将探讨如何[负责任地构建生成式 AI](https://github.com/microsoft/generative-ai-for-beginners/blob/d8ec07e31c4b32bd283d565c1abd9b58bb5cf2e8/translations/zh-CN/03-using-generative-ai-responsibly/README.md?WT.mc_id=academic-105485-koreyst)!
---
<!-- CO-OP TRANSLATOR DISCLAIMER START -->
**免责声明**:
本文件由 AI 翻译服务 [Co-op Translator](https://github.com/Azure/co-op-translator) 翻译完成。尽管我们力求准确,但请注意,自动翻译可能包含错误或不准确之处。原始语言版文件应视为权威来源。对于重要信息,建议使用专业人工翻译。我们对因使用本翻译而产生的任何误解或误释不承担责任。
<!-- CO-OP TRANSLATOR DISCLAIMER END -->
---
## 版权与许可
```text
MIT License
Copyright (c) Microsoft Corporation.
Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:
The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE
```