 AI 智链谷
 问苏一二 ↗
社区交流 ·
小型语言模型简介 —— 面向初学者的生成式人工智能
开源教程转载|小型语言模型简介 —— 面向初学者的生成式人工智能。Microsoft 及项目贡献者编写,智链谷平台运营整理。
> 开源教程转载 · 由智链谷平台运营账号整理发布。作者:Microsoft 及项目贡献者。
> [查看原文](https://github.com/microsoft/generative-ai-for-beginners/blob/d8ec07e31c4b32bd283d565c1abd9b58bb5cf2e8/translations/zh-CN/19-slm/README.md) · MIT 许可,完整声明见文末。
# 小型语言模型简介 —— 面向初学者的生成式人工智能
生成式人工智能是人工智能中一个引人入胜的领域,专注于创建能够生成新内容的系统。这些内容可以涵盖文本、图像、音乐,甚至完整的虚拟环境。生成式人工智能最令人兴奋的应用之一就是语言模型领域。
## 什么是小型语言模型?
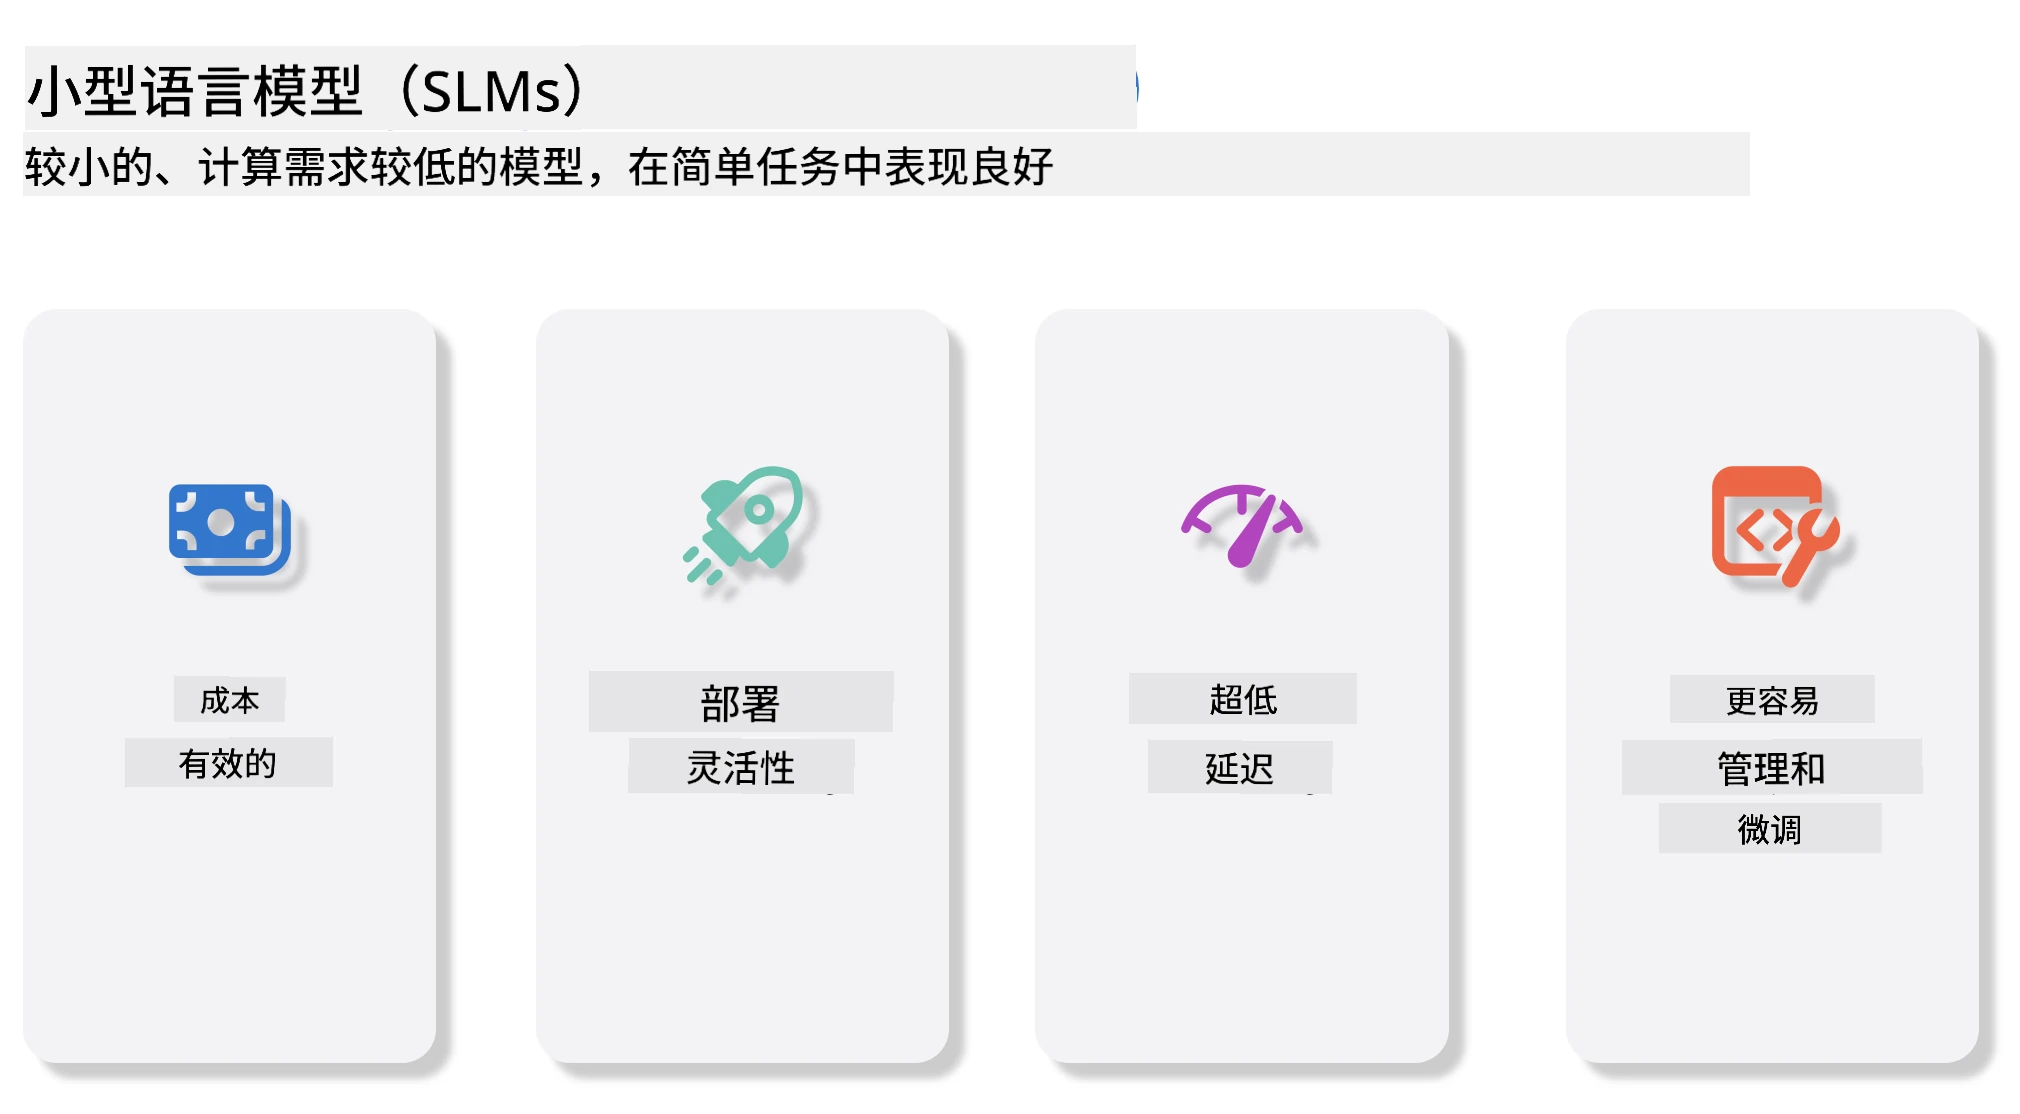
小型语言模型(SLM)是大型语言模型(LLM)的缩小版,利用了LLM的许多架构原理和技术,同时显著降低了计算资源需求。
SLM是设计用来生成类人文本的语言模型子集。与大型语言模型(如GPT-4)相比,SLM更紧凑、高效,非常适合计算资源有限的应用场景。尽管体积较小,它们仍能执行多种任务。通常,SLM通过压缩或蒸馏LLM构建,旨在保留原始模型的大部分功能和语言能力。模型尺寸的缩小减少了整体复杂性,使SLM在内存使用和计算需求方面更为高效。尽管做了这些优化,SLM依然可以执行广泛的自然语言处理(NLP)任务:
- 文本生成:创造连贯且语境相关的句子或段落。
- 文本补全:基于给定提示预测并完成句子。
- 翻译:将文本从一种语言转换为另一种语言。
- 摘要:将冗长文本浓缩为简洁易读的摘要。
尽管在性能或理解深度上与大型模型相比有所取舍。
## 小型语言模型如何工作?
SLM通过大量文本数据进行训练。在训练过程中,它们学习语言的模式和结构,能够生成语法正确且符合上下文的文本。训练过程包括:
- 数据收集:从多种来源收集大量文本数据。
- 预处理:清洗和整理数据以适合训练。
- 训练:使用机器学习算法教模型理解并生成文本。
- 微调:调整模型以提升特定任务的性能。
SLM的发展符合在资源受限环境(如移动设备或边缘计算平台)中部署模型的需求,在这些环境下,完整的LLMs因资源消耗过大而不够实用。SLM通过注重效率,在性能与可访问性之间取得平衡,从而使其能够更广泛地应用于各种领域。
## 学习目标
本节课希望介绍SLM的相关知识,并结合微软Phi-3学习文本内容、视觉和专家模型(MoE)中的不同场景。
课程结束时,你应该能够回答以下问题:
- 什么是SLM?
- SLM与LLM有何区别?
- 什么是微软Phi-3/3.5系列?
- 如何使用微软Phi-3/3.5系列进行推理?
准备好了么?我们开始吧。
## 大型语言模型(LLMs)与小型语言模型(SLMs)的区别
LLM和SLM均建立在概率机器学习的基础原则上,在架构设计、训练方法、数据生成流程和模型评估技术方面采用类似方法。然而,这两类模型在几个关键因素上有所不同。
## 小型语言模型的应用
SLM有广泛的应用领域,包括:
- 聊天机器人:为客户提供支持,并以对话形式与用户互动。
- 内容创作:辅助写作者生成创意,甚至起草整篇文章。
- 教育:帮助学生完成写作任务或学习新语言。
- 无障碍:为残障人士创建辅助工具,如文本转语音系统。
<strong>规模</strong>
LLM和SLM的一个主要区别在于模型规模。像ChatGPT(GPT-4)这样的LLM可能包含约1.76万亿参数,而开源SLM如Mistral 7B则设计为大约70亿参数。这种差异主要源于模型架构和训练过程的不同。举例来说,ChatGPT采用编码器-解码器框架内的自注意力机制,而Mistral 7B使用滑动窗口注意力,使得在仅解码器模型内更高效地训练。这种架构差异对模型的复杂度和性能有深远影响。
<strong>理解力</strong>
SLM通常针对特定领域进行性能优化,使其高度专业化,但可能在跨多领域提供广泛语境理解方面受限。相比之下,LLM旨在模拟更全面的人类智能。由庞大且多样化的数据集训练,LLM设计为能在多种领域表现良好,具备更强的多功能性和适应性。因此,LLM更适合广泛的下游任务,如自然语言处理和编程。
<strong>计算需求</strong>
LLM的训练和部署是资源密集型的过程,通常需要强大的计算基础设施,包括大规模GPU集群。例如,从零开始训练ChatGPT之类的模型,可能需数千GPU长时间并行运算。相比之下,参数量较少的SLM对计算资源要求更低。像Mistral 7B这类模型,可以在配备中等GPU的本地机器上训练和运行,但训练仍需多个GPU数小时。
<strong>偏见</strong>
偏见是LLM的一个已知问题,主要源于训练数据的性质。这些模型依赖互联网上的原始公开数据,可能对某些群体的代表性不足或错误标注,或反映出因方言、地理差异和语法规则导致的语言偏见。此外,LLM复杂的架构可能无意中加剧偏见,若未进行细致微调,偏见可能难以察觉。相比之下,SLM训练自更受限制的领域特定数据集,本质上对偏见的敏感度较低,但并非完全免疫。
<strong>推理</strong>
SLM体积较小,使其在推理速度上具有显著优势,可以高效地在本地硬件生成输出,无需大量并行计算资源。相反,LLM由于体积庞大且复杂,往往需大量并行计算支持,才能达到可接受的推理时间。尤其在多用户同时使用时,LLM的响应时间会进一步变慢,尤其是在大规模部署情况下。
总结来说,虽然LLM和SLM都基于机器学习的基础,但它们在模型大小、资源需求、上下文理解、偏见敏感度和推理速度方面存在显著差异。这些差异反映了它们在不同用例中的适用性,LLM更通用但资源消耗大,SLM则在特定领域内更高效,计算需求较低。
***注意:本课将以Microsoft Phi-3 / 3.5为例介绍SLM。***
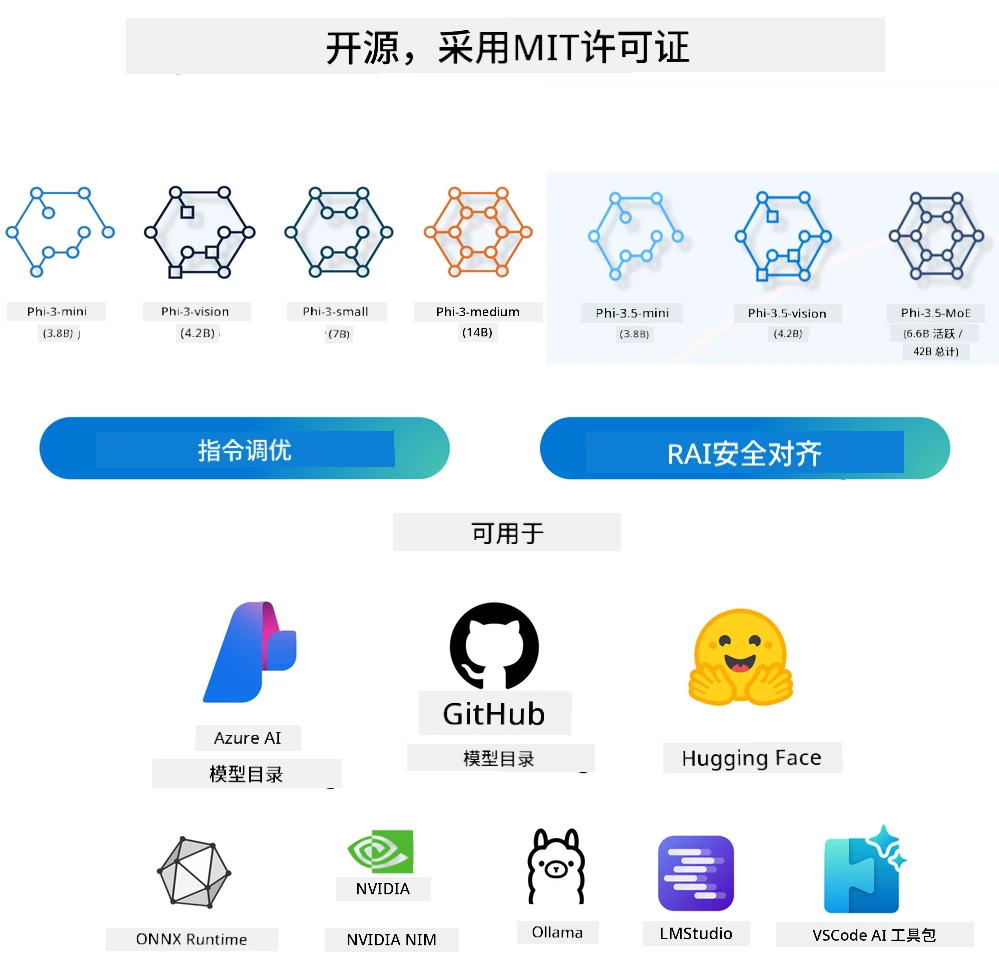
## 介绍Phi-3 / Phi-3.5家族
Phi-3 / 3.5家族主要面向文本、视觉和Agent(MoE)应用场景:
### Phi-3 / 3.5 指令模型
主要用于文本生成、聊天补全和内容信息抽取等。
**Phi-3-mini**
3.8B参数的语言模型可在Microsoft Foundry、Hugging Face和Ollama上使用。Phi-3模型在关键基准测试上大幅优于同等或更大规模的语言模型(见下文基准数据,数字越大越好)。Phi-3-mini性能优于两倍规模的模型,Phi-3-small和Phi-3-medium性能甚至超过更大的模型,包括GPT-3.5。
**Phi-3-small & medium**
仅7B参数的Phi-3-small在多种语言、推理、编码和数学基准测试中击败GPT-3.5T。
14B参数的Phi-3-medium延续了这一趋势,性能超过Gemini 1.0 Pro。
**Phi-3.5-mini**
可视为Phi-3-mini的升级版。参数未变,但提升了多语言支持能力(支持20+语言:阿拉伯语、中文、捷克语、丹麦语、荷兰语、英语、芬兰语、法语、德语、希伯来语、匈牙利语、意大利语、日语、韩语、挪威语、波兰语、葡萄牙语、俄语、西班牙语、瑞典语、泰语、土耳其语、乌克兰语)且增强了长上下文支持。
拥有3.8B参数的Phi-3.5-mini在性能上优于同等规模语言模型,且可媲美两倍规模模型。
### Phi-3 / 3.5 视觉模型
可以将Phi-3/3.5的Instruct模型看作Phi的理解能力,视觉模型则赋予Phi“眼睛”去理解世界。
**Phi-3-Vision**
仅4.2B参数的Phi-3-vision延续了此趋势,在一般视觉推理任务、OCR以及表格和图表理解任务中表现优于更大模型,如Claude-3 Haiku和Gemini 1.0 Pro V。
**Phi-3.5-Vision**
Phi-3.5-Vision是Phi-3-Vision的升级版,新增多图像支持。可以将其视为视觉能力的提升,不仅能看图片,还能看视频。
Phi-3.5-vision在OCR、表格和图表理解任务上优于更大模型如Claude-3.5 Sonnet和Gemini 1.5 Flash,在通用视觉知识推理任务上表现相当。支持多帧输入,即对多张输入图片进行推理。
### Phi-3.5-MoE
***专家混合(MoE)*** 使得模型预训练时计算量大幅减少,这意味着在相同计算预算下,模型或数据集规模可以显著扩大。尤其是MoE模型在预训练过程中实现与其密集模型对应物相同性能的速度更快。
Phi-3.5-MoE包含16个3.8B专家模块。仅6.6B激活参数的Phi-3.5-MoE在推理、语言理解和数学能力上与更大模型相当。
根据不同场景,我们可以使用Phi-3/3.5家族模型。与LLM不同,Phi-3/3.5-mini或Phi-3/3.5-Vision可以部署在边缘设备上。
## 如何使用Phi-3/3.5家族模型
我们希望在不同场景下使用Phi-3/3.5。接下来,我们将基于不同场景介绍Phi-3/3.5的应用。
### 通过云API进行推理
**Microsoft Foundry模型**
> **注意:** GitHub Models将于2026年7月底退役。[Microsoft Foundry Models](https://ai.azure.com/catalog/models?WT.mc_id=academic-105485-koreyst)为直接替代方案。
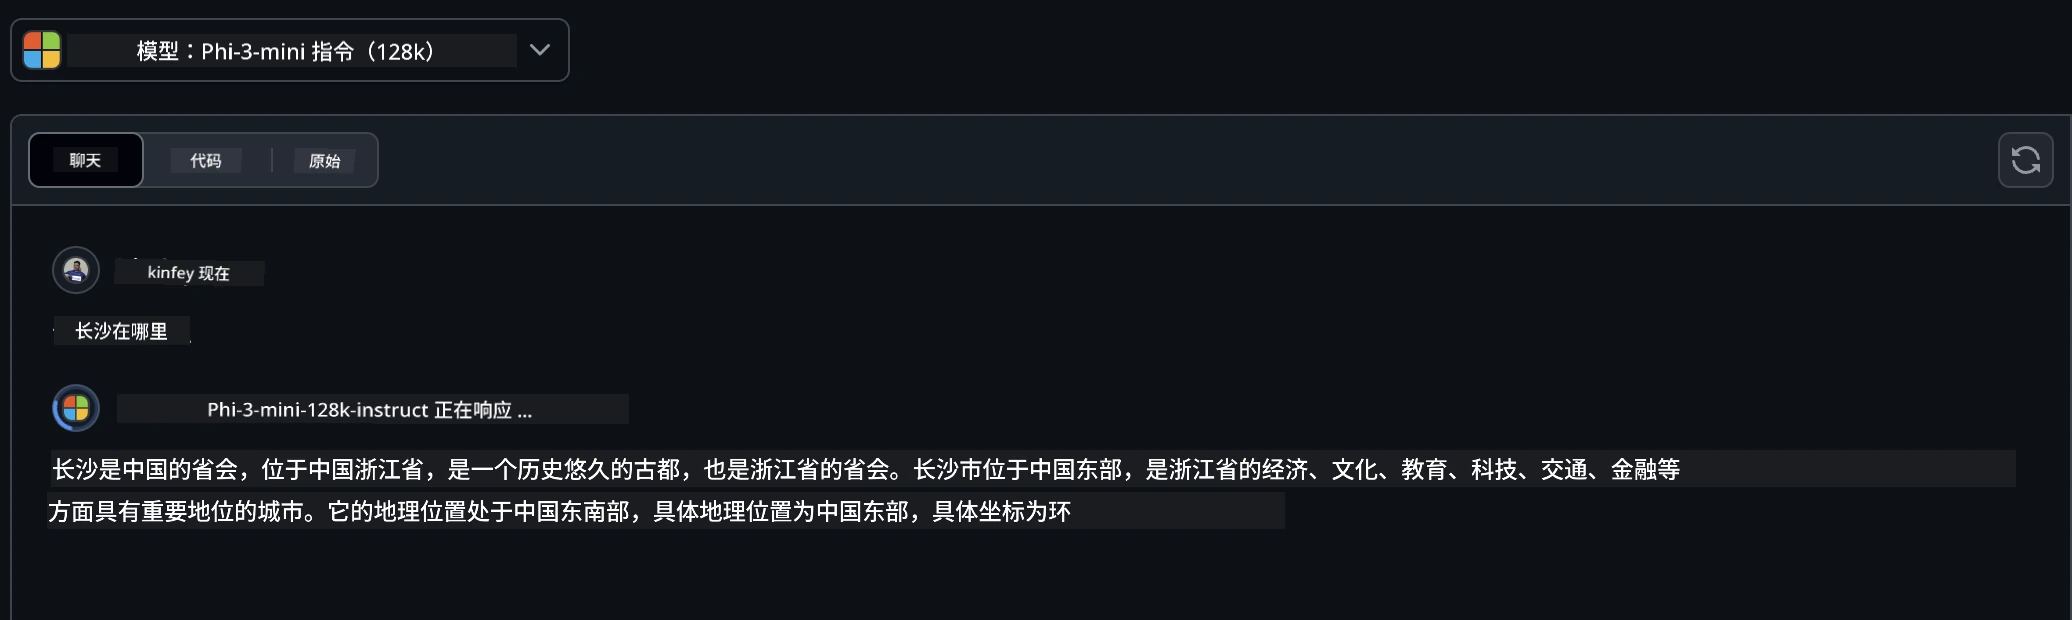
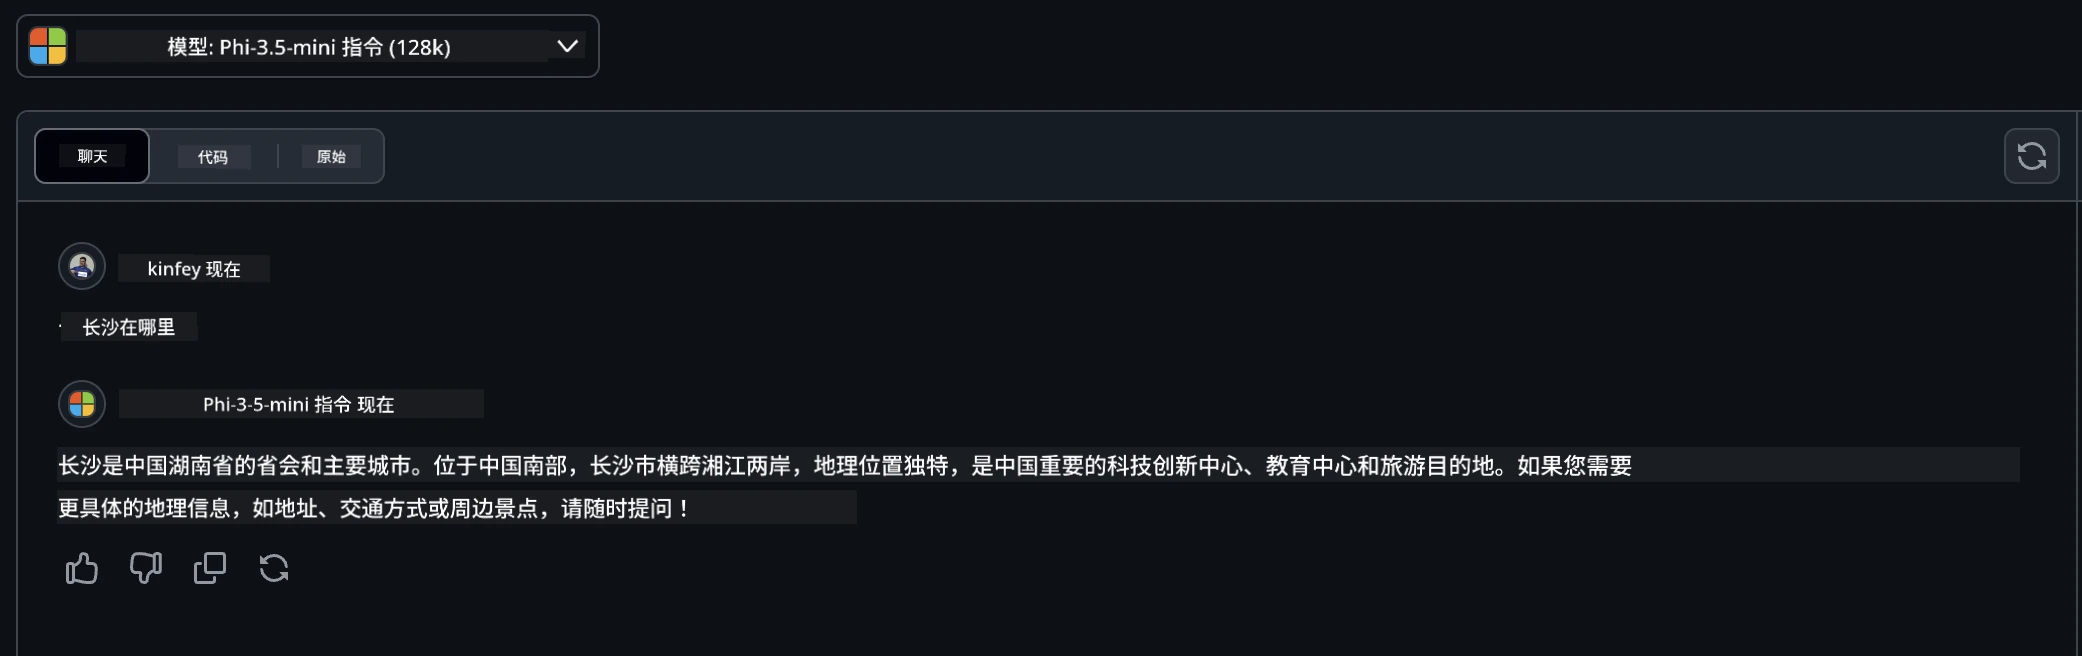
Microsoft Foundry Models是最直接的方式。您可以通过Foundry模型目录快速访问Phi-3/3.5-Instruct模型。结合Azure AI推理SDK / OpenAI SDK,您可以通过代码调用API完成Phi-3/3.5-Instruct调用,亦可通过Playground测试不同效果。
- 演示:Phi-3-mini与Phi-3.5-mini在中文场景中的效果对比
**Microsoft Foundry**
若要使用视觉和MoE模型,也可以通过Microsoft Foundry完成调用。如有兴趣,可阅读Phi-3 Cookbook,了解如何通过Microsoft Foundry调用Phi-3/3.5 Instruct、Vision、MoE [点击此链接](https://github.com/microsoft/Phi-3CookBook/blob/main/md/02.QuickStart/AzureAIStudio_QuickStart.md?WT.mc_id=academic-105485-koreyst)
**NVIDIA NIM**
除基于云的Microsoft Foundry模型目录外,您还可以使用[NVIDIA NIM](https://developer.nvidia.com/nim?WT.mc_id=academic-105485-koreyst)完成相关调用。您可以访问NVIDIA NIM完成Phi-3/3.5家族的API调用。NVIDIA NIM(NVIDIA推理微服务)是一套加速推理微服务,旨在帮助开发者高效部署AI模型于云端、数据中心及工作站等多种环境中。
以下是NVIDIA NIM的一些主要特性:
- **部署简便性:** NIM 允许通过一条命令部署 AI 模型,使其易于集成到现有工作流程中。
- **优化性能:** 它利用了 NVIDIA 预优化的推理引擎,如 TensorRT 和 TensorRT-LLM,确保低延迟和高吞吐量。
- **可扩展性:** NIM 支持 Kubernetes 上的自动扩展,使其能够有效处理不同的工作负载。
- **安全和控制:** 组织可以通过在自己管理的基础设施上自托管 NIM 微服务,保持对数据和应用的控制。
- **标准 API:** NIM 提供行业标准的 API,使构建和集成聊天机器人、AI 助理等 AI 应用变得容易。
NIM 是 NVIDIA AI Enterprise 的一部分,旨在简化 AI 模型的部署和运营,确保它们在 NVIDIA GPU 上高效运行。
- 演示:使用 NVIDIA NIM 调用 Phi-3.5-Vision-API [[点击此链接](https://github.com/microsoft/generative-ai-for-beginners/blob/d8ec07e31c4b32bd283d565c1abd9b58bb5cf2e8/translations/zh-CN/19-slm/python/Phi-3-Vision-Nividia-NIM.ipynb?WT.mc_id=academic-105485-koreyst)]
### 本地运行 Phi-3/3.5
推理是指针对 Phi-3 或任何类似 GPT-3 的语言模型,根据所接收的输入生成响应或预测的过程。当你向 Phi-3 提供提示或问题时,它会利用训练好的神经网络,通过分析训练数据中的模式和关系来推断最有可能且相关的回复。
**Hugging Face Transformer**
Hugging Face Transformers 是一个强大的库,专门用于自然语言处理(NLP)及其他机器学习任务。以下是一些关键点:
1. <strong>预训练模型</strong>:提供数千种预训练模型,可用于文本分类、命名实体识别、问答、摘要、翻译和文本生成等多种任务。
2. <strong>框架互操作性</strong>:该库支持多种深度学习框架,包括 PyTorch、TensorFlow 和 JAX。使得你可以在一个框架中训练模型,然后在另一个框架中使用。
3. <strong>多模态能力</strong>:除了 NLP,该库还支持计算机视觉(如图像分类、目标检测)和音频处理(如语音识别、音频分类)任务。
4. <strong>易用性</strong>:该库提供 API 和工具,使得下载和微调模型变得简单,适合初学者和专家使用。
5. <strong>社区和资源</strong>:Hugging Face 拥有活跃的社区和丰富的文档、教程与指南,帮助用户快速上手并充分利用该库。
[官方文档](https://huggingface.co/docs/transformers/index?WT.mc_id=academic-105485-koreyst) 或其 [GitHub 仓库](https://github.com/huggingface/transformers?WT.mc_id=academic-105485-koreyst)。
这是最常用的方法,但它也需要 GPU 加速。毕竟,诸如 Vision 和 MoE 的场景需要大量计算,如果未量化,在 CPU 上会非常慢。
- 演示:使用 Transformer 调用 Phi-3.5-Instruct [点击此链接](https://github.com/microsoft/generative-ai-for-beginners/blob/d8ec07e31c4b32bd283d565c1abd9b58bb5cf2e8/translations/zh-CN/19-slm/python/phi35-instruct-demo.ipynb?WT.mc_id=academic-105485-koreyst)
- 演示:使用 Transformer 调用 Phi-3.5-Vision [点击此链接](https://github.com/microsoft/generative-ai-for-beginners/blob/d8ec07e31c4b32bd283d565c1abd9b58bb5cf2e8/translations/zh-CN/19-slm/python/phi35-vision-demo.ipynb?WT.mc_id=academic-105485-koreyst)
- 演示:使用 Transformer 调用 Phi-3.5-MoE [点击此链接](https://github.com/microsoft/generative-ai-for-beginners/blob/d8ec07e31c4b32bd283d565c1abd9b58bb5cf2e8/translations/zh-CN/19-slm/python/phi35_moe_demo.ipynb?WT.mc_id=academic-105485-koreyst)
**Ollama**
[Ollama](https://ollama.com/?WT.mc_id=academic-105485-koreyst) 是一个平台,旨在让你更容易在本地机器上运行大型语言模型(LLM)。它支持各种模型,如 Llama 3.1、Phi 3、Mistral 和 Gemma 2 等。该平台通过将模型权重、配置和数据打包成一个单一包,简化了定制和创建自己模型的过程,使用户更易上手。Ollama 支持 macOS、Linux 和 Windows。如果你想实验或部署 LLM 而不依赖云服务,这是一个极好的工具。Ollama 是最直接的方式,只需执行以下命令即可。
```bash
ollama run phi3.5
```
**Foundry Local**
[Foundry Local](https://foundrylocal.ai?WT.mc_id=academic-105485-koreyst) 是微软提供的脱机设备端运行时,能让你在自己的硬件上运行例如 Phi 这样的模型——无需 Azure 订阅、API 密钥或网络连接。它会自动选择最佳执行提供者(NPU、GPU,或 CPU),并暴露一个兼容 OpenAI 的接口,因此现有的 `openai`/Azure AI 推理 SDK 代码只需做最小改动即可指向它。请参阅 [Foundry Local 文档](https://learn.microsoft.com/azure/ai-foundry/foundry-local/get-started?WT.mc_id=academic-105485-koreyst) 以开始使用。
```bash
winget install Microsoft.FoundryLocal
foundry model run phi-3.5-mini
```
或直接在 Python 中使用 SDK:
```bash
pip install foundry-local-sdk
```
```python
from foundry_local import FoundryLocalManager
manager = FoundryLocalManager("phi-3.5-mini")
print(manager.endpoint, manager.api_key)
```
**ONNX Runtime for GenAI**
[ONNX Runtime](https://github.com/microsoft/onnxruntime-genai?WT.mc_id=academic-105485-koreyst) 是一个跨平台的推理和训练机器学习加速器。ONNX Runtime for Generative AI (GENAI) 是一款强大工具,可帮助你在各种平台上高效运行生成式 AI 模型。
## 什么是 ONNX Runtime?
ONNX Runtime 是一个开源项目,支持机器学习模型的高性能推理。它支持 Open Neural Network Exchange(ONNX)格式的模型,这是机器学习模型的标准表示格式。ONNX Runtime 推理可加速用户体验并降低成本,支持来自 PyTorch、TensorFlow/Keras 等深度学习框架的模型,也支持 scikit-learn、LightGBM、XGBoost 等传统机器学习库的模型。ONNX Runtime 兼容不同硬件、驱动和操作系统,通过利用硬件加速器以及图优化和转换实现最佳性能。
## 什么是生成式 AI?
生成式 AI 指能够基于训练数据生成新内容(如文本、图像或音乐)的 AI 系统。示例包括 GPT-3 这类语言模型和 Stable Diffusion 这类图像生成模型。ONNX Runtime for GenAI 库为 ONNX 模型提供生成式 AI 循环,包括 ONNX Runtime 推理、logits 处理、搜索和采样,以及 KV 缓存管理。
## ONNX Runtime for GENAI
ONNX Runtime for GENAI 扩展了 ONNX Runtime 的功能,以支持生成式 AI 模型。以下是其主要特性:
- **广泛的平台支持:** 适用于包括 Windows、Linux、macOS、Android 和 iOS 等多种平台。
- **模型支持:** 支持许多流行的生成式 AI 模型,如 LLaMA、GPT-Neo、BLOOM 等。
- **性能优化:** 包括对多种硬件加速器(如 NVIDIA GPU、AMD GPU 等)的优化。
- **易用性:** 提供 API 方便集成到应用程序中,允许你以最少代码生成文本、图像和其他内容。
- 用户可以调用高级 generate() 方法,或在循环中逐次运行模型,每次生成一个令牌,并可在循环内选择性地更新生成参数。
- ONNX Runtime 还支持贪婪/束搜索和 TopP、TopK 采样来生成令牌序列,并内置了诸如重复惩罚等 logits 处理。你也可以轻松添加自定义评分。
## 快速开始
若要开始使用 ONNX Runtime for GENAI,可以按以下步骤进行:
### 安装 ONNX Runtime:
```Python
pip install onnxruntime
```
### 安装生成式 AI 扩展:
```Python
pip install onnxruntime-genai
```
### 运行模型:以下是 Python 中的简单示例:
```Python
import onnxruntime_genai as og
model = og.Model('path_to_your_model.onnx')
tokenizer = og.Tokenizer(model)
input_text = "Hello, how are you?"
input_tokens = tokenizer.encode(input_text)
output_tokens = model.generate(input_tokens)
output_text = tokenizer.decode(output_tokens)
print(output_text)
```
### 演示:使用 ONNX Runtime GenAI 调用 Phi-3.5-Vision
```python
import onnxruntime_genai as og
model_path = './Your Phi-3.5-vision-instruct ONNX Path'
img_path = './Your Image Path'
model = og.Model(model_path)
processor = model.create_multimodal_processor()
tokenizer_stream = processor.create_stream()
text = "Your Prompt"
prompt = "<|user|>\n"
prompt += "<|image_1|>\n"
prompt += f"{text}<|end|>\n"
prompt += "<|assistant|>\n"
image = og.Images.open(img_path)
inputs = processor(prompt, images=image)
params = og.GeneratorParams(model)
params.set_inputs(inputs)
params.set_search_options(max_length=3072)
generator = og.Generator(model, params)
while not generator.is_done():
generator.compute_logits()
generator.generate_next_token()
new_token = generator.get_next_tokens()[0]
output = tokenizer_stream.decode(new_token)
print(tokenizer_stream.decode(new_token), end='', flush=True)
```
<strong>其他</strong>
除了 ONNX Runtime、Ollama 和 Foundry Local 参考方法外,我们还可以基于不同厂商提供的模型参考方法完成量化模型的参考。例如 Apple Metal 的 Apple MLX 框架、带 NPU 的 Qualcomm QNN,Intel OpenVINO 支持 CPU/GPU 等。你还可以从 [Phi-3 Cookbook](https://github.com/microsoft/phi-3cookbook?WT.mc_id=academic-105485-koreyst) 获取更多内容。
## 更多
我们已经了解了 Phi-3/3.5 家族的基础知识,但要深入了解 SLM 需要更多知识。你可以在 Phi-3 Cookbook 中找到答案。如果你想了解更多,请访问 [Phi-3 Cookbook](https://github.com/microsoft/phi-3cookbook?WT.mc_id=academic-105485-koreyst)。
---
<!-- CO-OP TRANSLATOR DISCLAIMER START -->
**免责声明**:
本文件由 AI 翻译服务 [Co-op Translator](https://github.com/Azure/co-op-translator) 翻译完成。尽管我们力求准确,但请注意,自动翻译可能包含错误或不准确之处。原始语言版文件应视为权威来源。对于重要信息,建议使用专业人工翻译。我们对因使用本翻译而产生的任何误解或误释不承担责任。
<!-- CO-OP TRANSLATOR DISCLAIMER END -->
---
## 版权与许可
```text
MIT License
Copyright (c) Microsoft Corporation.
Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:
The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE
```